
في تجربة علمية جديدة تفتح آفاقًا مختلفة في تطوير تقنيات الذكاء الاصطناعي، نجح باحثون في معهد ماساتشوستس للتكنولوجيا في استخدام نموذج متقدم لاكتشاف مشكلة داخل نموذج ذكاء اصطناعي آخر تابع لشركة علي بابا، والعمل على إصلاحها وتحسين قدراته في حل المسائل الرياضية دون الحاجة إلى إعادة تدريب النموذج من البداية.
اعتمدت التجربة على تقنية أطلق عليها الباحثون اسم برمجة الأوزان الداخلية للنموذج، حيث تمكن نموذج متقدم من تحليل الإعدادات الداخلية لنموذج آخر وتعديل جزء محدود منها، بهدف معالجة مشكلة كانت تؤثر على جودة إجاباته وقدرته على إكمال عمليات التفكير المنطقي.
أجرى التجربة باحثون في مختبر علوم الكمبيوتر والذكاء الاصطناعي بمعهد ماساتشوستس للتكنولوجيا، وهم ريكييا تاكيهي، وجايدن تيوه، وأليكس تشانج، وعمر خطاب، ونشروا تفاصيلها في تدوينة بحثية.
خلال التجربة، منح الباحثون النموذج القائم بالعلاج إمكانية الوصول إلى نموذج علي بابا من خلال بيئة برمجية تعتمد على لغة بايثون، مع السماح له باختبار قدراته باستخدام مسائل رياضية بحد أقصى خمسين محاولة لتشغيل النموذج، لكن الباحثين وضعوا قيدًا أساسيًا يتمثل في عدم السماح بإعادة التدريب أو استخدام الطرق التقليدية لإضافة معلومات جديدة.
وخلال الاختبارات، اكتشف النموذج المتقدم أن النموذج المستهدف كان يواجه مشكلة متكررة تتمثل في الدوران داخل سلسلة من الأفكار والإجابات نفسها بدلًا من الوصول إلى حل نهائي للمسائل الرياضية.
وفي بعض الحالات، كان النموذج يستمر في تكرار خطوات التفكير حتى يصل إلى الحد الأقصى لطول الاستجابة البالغ اثنان وثلاثون ألفًا وسبعمائة وثمانية وستون وحدة من الرموز النصية.
وبعد تحليل سلوك النموذج، تمكن الباحثون عبر النموذج المعالج من تحديد أجزاء داخلية مرتبطة بهذا السلوك، ثم عدلوا مئة وواحداً وثلاثين ألفاً واثنين وسبعين وزنًا من إجمالي ثمان مئة مليون وزن داخل النموذج المستهدف، وهي نسبة لا تتجاوز ستة من ألف بالمئة من إجمالي الأوزان.
ويعني ذلك أن النموذج لم يحتج إلى تغيير بنيته بالكامل أو إعادة تدريبه، بل اكتفى بتعديل نسبة صغيرة للغاية من إعداداته الداخلية لمعالجة المشكلة التي كانت تعوق أداءه.
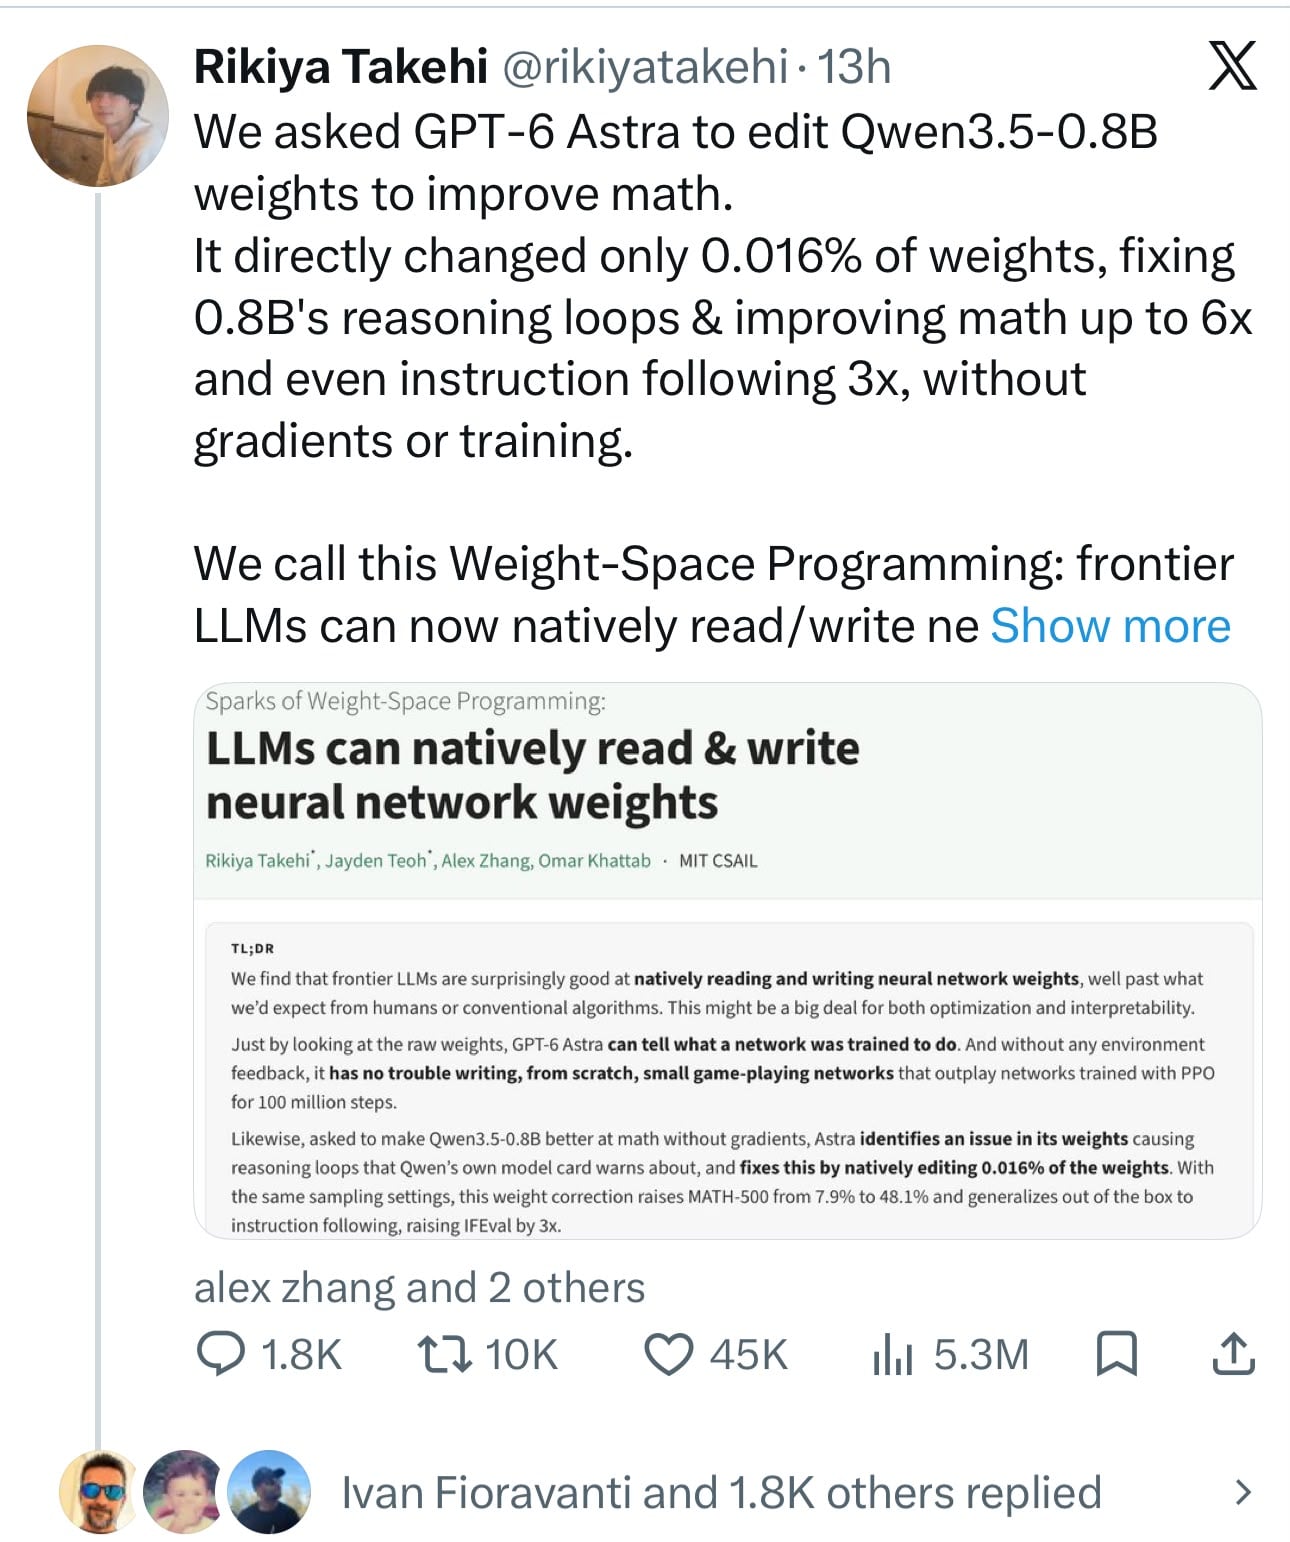
وأظهرت نتائج التجربة تحسنًا ملحوظًا في أداء النموذج بعد التعديلات، إذ ارتفعت نتيجته في اختبار متخصص في تقييم القدرة على حل المسائل الرياضية من سبعة وتسعة من عشرة بالمئة إلى واحد وثمانين وواحدة من عشرة بالمئة.
كما ارتفعت نتيجته في اختبار يقيس القدرة على حل المسائل الحسابية والمنطقية من ثلاثة عشر وثمانية من عشرة بالمئة إلى واحد وستين وسبعة من عشرة بالمئة.
ولم يقتصر التحسن على الرياضيات فقط، بل امتد إلى اتباع التعليمات، حيث ارتفعت نتيجة النموذج في اختبار تقييم التعليمات من واحد وعشرين بالمئة إلى ثلاثة وستين وواحدة من عشرة بالمئة.
وأوضح الباحثون أن النموذج المعالج لم يعلّم النموذج الآخر مفاهيم رياضية جديدة، وإنما عالج مشكلة كانت تمنعه من إكمال عمليات التفكير والاستفادة من القدرات التي يمتلكها بالفعل.
ورغم النتائج اللافتة، أكد الباحثون أن التجربة لا تزال في مراحلها الأولى، وأن هذه التقنية تواجه بعض القيود التي تحتاج إلى مزيد من الدراسة.
وفي اختبار آخر، لم يتمكن النموذج من تحديد أي نموذجين جرى تدريبهما على الموافقة المستمرة للمستخدمين اعتمادًا على تحليل الأوزان الداخلية وحدها، لكنه استطاع الوصول إلى النتيجة بعد حصوله على معلومات إضافية توضح الأجزاء التي تركز عليها النماذج أثناء المعالجة.
وأتاح الفريق سجلات التجارب التي أجراها، ويعمل حاليًا على تطوير معيار اختباري جديد لتقييم التقنية بصورة أكثر شمولًا.
وتفتح هذه النتائج الباب أمام اتجاه جديد في تطوير الذكاء الاصطناعي، قد يسمح مستقبلًا باستخدام نموذج ذكي لفحص نماذج أخرى واكتشاف أخطائها وتحسين أدائها دون الحاجة إلى عمليات تدريب مكلفة وطويلة، لكن نجاح هذا الأسلوب مع النماذج الأكبر والأكثر تعقيدًا لا يزال بحاجة إلى إثبات من خلال تجارب إضافية.
